SAP HANAにおける大規模テーブルの再パーティション対応
■ 前提
レイエントシステムで維持運用保守を担当しているお客様のSAP S/4HANAシステム(SAP HANAデータベース)で、日々の運用によりパーティション済みのテーブルでレコード件数が増加し、SAP HANAのレコード数上限の制約に達する可能性が出てきたため、再パーティションが必要となりました。
再パーティションが必要となる対象テーブルは、既にパーティション分割されており、大量のレコードが登録されていました。このため、再パーティション作業の長時間化が見込まれましたが、本番環境では長時間のシステム停止ができないため、作業時間を短縮する方法の検討が必要となりました。
また、対象テーブルは更新頻度が高いテーブルとなり毎月のデータ量(レコード数)の増加が大きいテーブルとなるため、今後のレコード数増加を見据えたパーティション分割の検討も必要となりました。
レイエントシステムでは、パーティショニング方式の検討、作業時間短縮の検討と再パーティション作業を担当しました。
※ 本事例のお客様環境では、SAP HANA System Replication機能が有効になっておりますが、今回の事例ではパーティションに関してのみご説明します。
■ パーティション分割方式の検討
対象テーブルは「HASH分割」方式でパーティション分割していましたが、単純にHASH分割で再パーティションを実施しても、今後も繰り返し再パーティション作業が必要となることが明白でした。
このため、本事例では今後のデータ増加を見据えて、データの増加に合わせてパーティションが自動的に管理される「Dynamic Range分割」方式を採用し、再パーティションをすることにしました。
【システムスペックとテーブル情報】
| 項目 | 内容 | |
|---|---|---|
| プラットフォーム | Amazon Web Services(AWS) | |
| SAP HANAサーバスペック | CPU:448コア、メモリ:6TB (※1) | |
| SAP HANAストレージ構成 | Dataボリューム | 7.2 TB (※2) |
| Logボリューム | 525 GB (※2) | |
| テーブル総レコード数 | 167億件 | |
| テーブルサイズ(※3) | 852 GB | |
| パーティション分割方式(旧) | HASH Partitioning(8分割) | |
| パーティション分割方式(新) | Dynamic Range Partitioning | |
※1:SAP HANA System Replicationあり
※2:AWS EBSボリュームのタイプは「io2」
※3:実態・圧縮されているサイズ
しかし、今回の対象テーブルは非常に大規模であったため、一般的なパーティション分割方法では、処理時間やメモリ・ディスク容量などの面で課題が出てきました。
課題①:通常のパーティション分割では対応が難しい
今回のテーブルは、レコード数が167億件と大量のレコードを保持していました。そのため、テーブルに対してパーティションコマンドを実行して、手動で分割する通常のパーティション方法(※)でパーティショニングを実行したところ、実行から2時間ほどでディスクフルとなり、処理がハング状態となりました。
原因は、メモリボトルネックが発生し、デルタマージが完了できずにディスク使用量が増加したことでした。
※:通常のパーティション方法については、下記のブログをご参照ください。
ブログ「SAP HANAテーブルパーティショニング」
【対応】
今回は既存テーブルを直接再パーティションするのではなく、新しいパーティション構成を持つ別テーブルを作成して、既存テーブルからデータをインサートする方法を採用しました。
イメージとしては以下のような流れです。
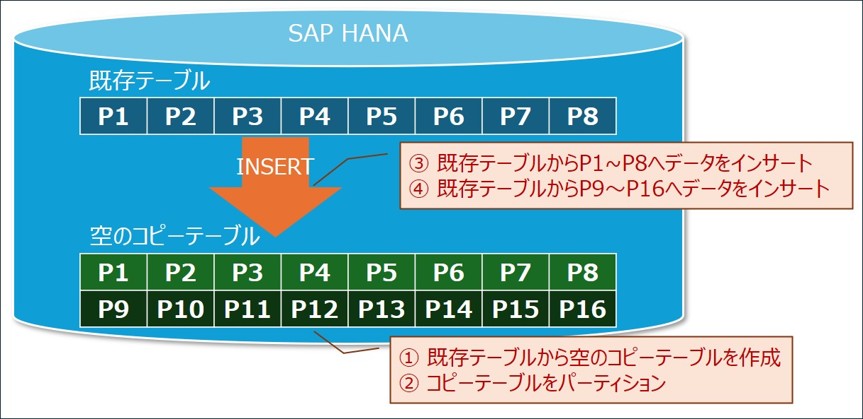
また、処理時間を短縮するため、インサート処理は並列度を上げて実行しました。HANA StudioのSQLコンソールを並列数分起動し、それぞれのコンソールからクエリを同時に実行することで並列実行することができます。
今回はリソース使用状況を踏まえ、1クエリあたり5億件前後で20並列程度のインサート処理を2サイクルに分けて実施する方式を採用しました。
【注意点】
Dynamic Rangeパーティションでパーティション分割すると、自動でパーティションが作成されますが、空のパーティションがあると自動で削除されてしまいます。Dynamic Rangeパーティションでは、以下の構成パラメータでDynamic Rangeパーティションしたテーブルの監視間隔が設定されています。
SAP Note 3417429 – SAP HANA Dynamic Range Partitioning
indexserver.ini -> partitioning -> dynamic_range_check_time_interval_sec
・設定した時間ごとに新しいパーティションを追加すべきかをチェック
・OTHERS以外の空パーティションを削除
・デフォルトは900秒(15分)
コピーテーブルをDynamic Rangeパーティションに設定してからインサート完了までに15分以上かかった場合、OTHERS以外のパーティションが自動で削除されてしまうため、作業実施前にパラメータ値を変更する必要があります。
今回はパラメータ値を「0(無効化)」に設定して、再パーティション作業を実施しました。
課題②:処理時間の長期化とI/Oボトルネック
課題①の対応により再パーティションはできましたが、インサート処理に時間がかかるという課題が発生しました。
検証時は108億件のインサートに39時間かかっており、本番機ではさらに時間がかかることが想定されました。
【SAP HANA側のボトルネック調査】
インサート処理時間が長くなっていたことから、まずはSAP HANA側にボトルネックが存在しないか確認しました。
SAP HANAの各種情報や処理状況を確認し、処理が長時間化している原因について調査しました。その結果、SAP HANA上では明確なボトルネックは確認できませんでした。そこで、SAP HANA内部だけではなく、SAP HANAが使用しているストレージ側の性能についても確認することにしました。
<確認ポイント>
| 確認項目 | 確認内容 |
|---|---|
| リソース | CPU使用率、メモリ使用率、ディスク使用率 |
| 処理状況の確認 | HANA Studio -> Administration Console -> [Performance]タブ -> [Job Progress]タブ |
| ログ | fullsysteminfodumpの取得 |
| I/O指標 | HANA_Configuration_MiniChecks(M0312~M0316) |
SAP Note 1999993 – How-To: Interpreting SAP HANA Mini Check Results
【LogボリュームのIOPSがボトルネック】
AWS EBSボリュームのリソース状況を確認したところ、SAP HANAのLogボリュームに設定されているEBSボリュームのIOPSが書き込み時のボトルネックとなっていることが判明しました。
大量データのインサート処理では、Dataボリュームだけではなく、トランザクションログなどの書き込みも発生します。そのため、SAP HANA側のリソース(CPU、メモリ、IO指標等)に余裕があったとしても、LogボリュームのI/O性能が処理速度を制限する場合があります。
今回のケースでは、SAP HANAが利用するEBSボリュームのI/O性能まで含めて確認することで、ボトルネックを特定することができました。
<確認ポイント>
| 確認項目 | 確認内容 |
|---|---|
| AWS EBS Volume | AWS CloudWatchでEBSボリュームのメトリクスを確認(※) |
※:今回のボトルネックだった項目は「書き込みオペレーション(Ops/秒)」でした。
【対応】
今回の対応としては、Logボリュームに使用しているEBSボリュームのIOPS設定を、再パーティション中に一時的に増加させました。
| 確認項目 | 設定値 |
|---|---|
| 既存の設定値 | 1,000 |
| 再パーティション中の設定値 | 32,000 |
※ 実際に使用したIOPSは14,000程度(108億件のエントリを21並列で実施した場合)
【インサート時間(検証時の時間)】
AWS EBSボリュームのIOPSの設定を変更することで、検証時のインサート時間が大幅に短縮されました。
| 変更前 | 変更後 |
|---|---|
| 約39時間 | 約3.5時間 |
課題③:大量データのインサートによるメモリ・ディスク不足
別テーブルへの大量のインサートを行う場合、システムのメモリやディスク使用量についても考慮する必要があります。
SAP HANAでは、インサートしたデータはDelta領域に蓄積されるため、インサートを大量に実行するとメモリやディスクの使用量が増加します。
今回も、既存テーブルのデータ量が非常に大きかったため、一度にすべてのデータをインサートするとメモリ・ディスク不足となる課題が発生しました。
【対応①:サイズの大きいテーブルのアンロード】
まず、インサート開始前に、メモリ上にロードされていた不要なテーブルをアンロードし、あらかじめ処理に使用できるメモリを確保しました。
SAP HANAでは、テーブルをアンロードしてもディスク上のデータが削除されるわけではないため、必要になれば再度ロードすることができます。
今回の作業では、不要なテーブルを事前にアンロードすることで、メモリに余裕を持たせた上で作業を実施しました。
注意点として、アンロードしたテーブルはSAP HANA起動時にはメモリにロードされず、アクセス時にディスクからメモリへのロードが始まります。そのため、作業後に明示的にロードしておくことが望ましいです。
・アンロード
UNLOAD “<スキーマ名>”.”<テーブル名>”;
・ロード
LOAD “<スキーマ名>”.”<テーブル名>” ALL;
【対応②:インサートを2回に分割】
今回の再パーティションでは、1回で全レコードを既存テーブルからコピーテーブルへインサートするのではなく、2回に分けて実施しました。インサート処理を分けることで、メモリとディスク使用量の急激な増加を抑えることができます。
1回目のインサート後にメモリとディスクの使用状況を確認し、次のインサートが実行できる状態かを確認した上で、2回目のインサートを進めました。また、1回目と2回目でインサート対象となるパーティションを分けました。これは、2回目のインサート後に行うデルタマージ及び圧縮について、インサートでデータが追加されたパーティションのみを処理対象とするためです。
【対応③:手動デルタマージの実行】
各インサート後に手動デルタマージを実行し、Delta領域に蓄積されたデータをMain領域へマージすることで、メモリとディスクの使用量を減らしました。
注意点として、デルタマージを実行するとデルタマージ中に一時的にメモリ使用量が増加する(検証では500GB程度)ため、デルタマージ実行時のメモリも考慮する必要があります。
【対応④:手動圧縮を実施】
大量のデータを新規テーブルにインサートすると、データ量の増加に伴いディスクの使用量も増加します。
SAP HANAの仕様上、インサートしたデータは、まずDelta領域に無圧縮状態で格納されるため、インサート直後は特にディスク使用量が増加している状態となります。
そこで、ディスク使用量削減のため、インサート後に手動でデータの圧縮を実施しました。
圧縮についても、デルタマージと同様に2回目の圧縮は、2回目のインサート対象となったパーティションのみを対象に実施しました。
■ 課題を踏まえた対応手順と実績
最後に、これまでの課題に対応した手順と、各工程の実績についてご紹介します。
なお、本事例のお客様はSAP HANA System Replication機能(HSR)で障害・災害対策を行っていました。今回の事例ではパーティションに関してのみのご説明となりますので、以降でご説明する手順以外にHSRの解除、再同期などの作業が追加で必要となります。
【再パーティション手順】
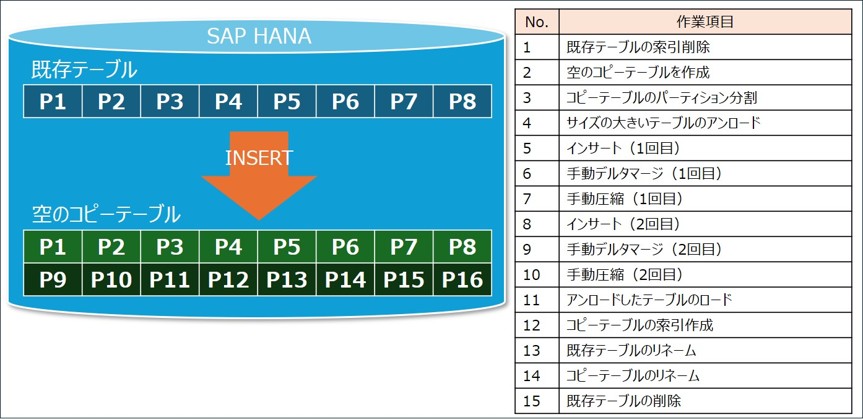
| No | 手順 |
|---|---|
| 1 | 既存テーブルの索引削除 |
| 索引はメモリを占有しているため、使用しない索引を削除することで使用メモリを削減。また、後続手順でのコピーテーブルの索引作成時に元のテーブルと同一の索引が存在すると、重複エラーが発生するため、事前に索引を削除してく。 <実行SQL> DROP INDEX “<インデックス名>” ; | |
| 2 | 空のコピーテーブルを作成 |
| 既存テーブルと同じカラム構成のコピーテーブルを作成。 <実行SQL> CREATE TABLE <コピーテーブル> LIKE <既存テーブル>; | |
| 3 | コピーテーブルをDynamic Range Partitioning方式でパーティション分割 |
| 作成したコピーテーブルは、パーティション分割されていないため、パーティション分割を実施。 <実行SQL> ALTER TABLE <テーブル名> PARTITION BY RANGE() (PARTITION YYYYMMM <= VALUES < YYYYMMM, (PARTITION YYYYMMM <= VALUES < YYYYMMM, … PARTITION OTHERS DYNAMIC THRESHOLD <しきい値>); | |
| 4 | サイズの大きいテーブルのアンロード |
| 利用可能なメモリ領域を増やすためにメモリにロードされているテーブルをディスクにアンロード。 <実行SQL> UNLOAD “<スキーマ名>”.”<テーブル名>”; | |
| 5 | 既存テーブルからコピーテーブルへレコードをインサート(1回目) |
| 1回目の対象となる既存テーブルのパーティション内のレコードをコピーテーブルへインサート。 <実行SQL> INSERT INTO <コピー先> (SELECT * FROM <コピー元> WHERE <主キー> <= XXX) | |
| 6 | 手動デルタマージ(1回目) |
| コピーテーブルのテーブル全体を対象にデルタマージを実行。 <実行SQL> MERGE DELTA OF <テーブル名> FORCE REBUILD; | |
| 7 | 手動圧縮(1回目) |
| コピーテーブルのテーブル全体を対象にデータ圧縮を実行。 <実行SQL> UPDATE <テーブル名> WITH PARAMETERS (‘OPTIMIZE_COMPRESSION’= ‘YES’); | |
| 8 | 既存テーブルからコピーテーブルへレコードをインサート(2回目) |
| 2回目の対象となる既存テーブルのパーティション内のレコードをコピーテーブルにインサート。 <実行SQL> INSERT INTO <コピー先> (SELECT * FROM <コピー元> WHERE <主キー> <= XXX) | |
| 9 | 手動デルタマージ(2回目) |
| 手順8でインサートされたコピーテーブルのパーティションを対象にデルタマージを実行。 <実行SQL> MERGE DELTA OF <テーブル名> PART FORCE REBUILD; | |
| 10 | 手動圧縮(2回目) |
| 手順8でインサートされたコピーテーブルのパーティションを対象にデータ圧縮を実行。 <実行SQL> UPDATE <テーブル名> WITH PARAMETERS (‘OPTIMIZE_COMPRESSION’= ‘YES’,’PART’ = ”); | |
| 11 | アンロードしたテーブルのロード |
| 手順4でメモリからアンロードしたテーブルをメモリにロード。 <実行SQL> LOAD “<スキーマ名>”.”<テーブル名>” ALL; | |
| 12 | コピーテーブルの索引作成 |
| コピーテーブルに既存テーブルで登録されていた索引を作成。 <実行SQL> CREATE CPBTREE INDEX “<インデックス名>” ON “<スキーマ名>”.”<コピーテーブル>” (“<フィールド名>” ASC); | |
| 13 | 既存テーブルのリネーム |
| コピーテーブルと既存テーブルを入れ替えるため、既存テーブルのテーブル名をリネーム。 <実行SQL> RENAME TABLE <既存テーブル名> <新しいテーブル名>; | |
| 14 | コピーテーブルのリネーム |
| コピーテーブルをリネーム前の既存テーブルと同じテーブル名にリネーム。 <実行SQL> RENAME TABLE <コピーテーブル名> <既存テーブル名>; | |
| 15 | 既存テーブルの削除 |
| 手順13でリネームした既存テーブルを削除。 <実行SQL> DROP TABLE <テーブル名>; |
【実績】
本番機でのインサート処理、デルタマージ、圧縮の1回目、2回目の実績は以下の通りとなります。
インサート処理
| 項目 | 所要時間 | メモリ使用量 | ディスク使用量 |
|---|---|---|---|
| 1回目(81億件、20並列) | 最大4時間31分 | 2TB増加 | 2.3TB増加 |
| 2回目(86億件、19並列) | 最大4時間35分 | 2.4TB増加 | 2.3TB増加 |
デルタマージ
| 項目 | 所要時間 | メモリ使用量 | ディスク使用量 |
|---|---|---|---|
| 1回目 (81億件) | 最大1時間26分 | 400GB減少 | 700GB減少 |
| 2回目(86億件) | 最大2時間5分 | 1TB減少 | 600GB減少 |
圧縮
本番機への再パーティションでは、圧縮コマンドは即時終了しました。これは、インサート完了後から手動での圧縮開始の間に、裏で自動圧縮が実行されていたためです。
検証では、メモリが700GB程度減少、ディスクが1TB減少することを確認できました。
本番機での既存テーブルからコピーテーブルへのレコードの移行は、約12.5時間程度で完了することができました。
■ 結果
今回の作業で、HASH PartitioningからDynamic Range Partitioningへの再パーティションに成功し、対象テーブルについては今後の定期的な手動再パーティションの必要性が大幅に低減しました。
また、インサートの分割やデルタマージ、圧縮などを組み合わせて対応することで、再パーティションの作業時間の短縮と大量データの安全な移行を実現しました。
特に、インサート処理時間については、SAP社と協力してSAP HANA側のボトルネックを調査した結果、明確なボトルネックは確認されず、ストレージ側のI/O性能が影響していることを突き止めることができました。
大規模テーブルの再パーティションでは、パーティション方式だけではなく、SAP HANAリソースやストレージ性能なども含めて事前に検討することが必要となります。
データが増加してから対応する場合、パーティション処理時間やリソース面での制約が大きくなるため、将来的なデータ増加を見据えて、あらかじめパーティション計画を立て、余裕のある段階で対応することが重要となります。
■ POINT
最後に今回の事例のポイントをご説明します。
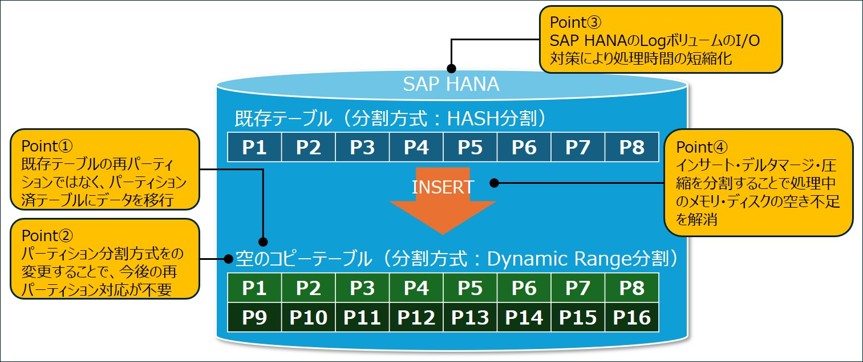
POINT①
対象テーブル(既存テーブル)のレコード数が多いため、既存テーブルに対して直接の再パーティションを行うとリソース不足で分割処理がエラーとなります。
このため、パーティション済の新規テーブル(空のコピーテーブル)を用意して、そのコピーテーブルにレコードを移行することでリソース不足による処理エラーを回避しました。
POINT②
コピーテーブルのパーティション方式を既存テーブルのパーティション方式で継続すると、この先も再パーティションを定期的に実施する必要が出てきますが、パーティション方式を「Dynamic Range Partitioning」方式に変更することで、今後の再パーティション対応が不要となり、運用コストを削減することができました。
POINT③
既存テーブルはレコード数が多いため、テーブルのサイズも大きくなっています。このためコピーテーブルへのインサート処理でSAP HANAのLogボリュームがボトルネックとなり、処理時間が長期化しました。
本環境がAWS上で運用されていることから、一時的にEBSボリュームのIOPSを変更してボトルネックを解消し、処理時間の短縮に成功しました。
POINT④
既存テーブルのサイズが大きいため、SAP HANAのメモリ・ディスクの使用量を意識する必要がありました。
既存テーブルからコピーテーブルへの1回のインサートでのデータの移行では、リソース不足が発生してデータが移行できません。インサート回数を増やすと、その分再パーティション全体の時間が延びてしまいます。
このため、インサートの回数・並列数の検討、インサートごとのデルタマージと圧縮を行うことで、リソース不足を解消しました。また、SAP HANAでは永続レイヤ(ディスク)にデータが保存されているため、特定のテーブルをメモリからディスクへアンロードできるSAP HANAの仕様を利用して、さらにリソースを確保し、安全な再パーティション作業を実現しました。
SAP製品の導入・移行・運用保守に関して、お気軽に相談下さい。
レイエントシステムではSAP製品の新規導入からシステム移行、運用保守までご対応します。
<お問い合わせ>